Privát AI – Agent Orchestration / GraphRAG Platform
Hogyan talál, és hogyan válaszol a Privát AI.
A válasz nem egyetlen modellhívás eredménye, hanem egy kódban rögzített, lépésenként naplózott folyamaté: a kérdés megértésétől a keresésen és az ellenőrzésen át a forrásjelölt válaszig.
Egy kérdés útja
Nyolc lépés, a vezérlés végig a kódban.
A nyelvi modell a kérdés átírásában, az osztályozásban, az ellenőrzésekben és a végső válaszban vesz részt. A lépések sorrendjét, az eszközök futtatását, a keresést és a kontextus összeállítását a vezérlő alkalmazás kódja végzi. A paraméterek kinyerése és a fogalmazás a modell feladata, így ezek kimenete futásonként eltérhet, de minden modellkérés és válasz, az eszközök döntései és a pontszámok naplózottak: utólag pontosan visszakövethető, mi történt és miért.
- 1Nyelv, normalizálás A kérdező nyelvének felismerése, a kérdés átfogalmazása, kulcsszavak és szinonimák gyűjtése, a gyanús kérések jelzése. Itt dől el, hogy kell-e egyáltalán keresni.
- 2Osztályozás Kérdés vagy utasítás? Az összetett kérdést a rendszer részkérdésekre bontja, és mindegyik saját keresést kap.
- 3Eszközök Részkérdésenként kiválasztódnak a feladathoz illő eszközök, például mélykeresés vagy külső rendszerek lekérdezése.
- 4Keresés Kulcsszavas, vektoros és tudásgráf alapú keresés több szinten, pontszám-összevonással és újrarangsorolással.
- 5Ellenőrzés Ellenőrzi, hogy a talált kontextus elég-e a válaszhoz. Ha nem, a releváns oldalak környezetében keres tovább.
- 6Kontextus Teljes oldalak, rangsor szerint, a részkérdések eredményeinek egyesítésével.
- 7Válasz Streamelt, forrásjelölt válasz a helyi nyelvi modelltől, a forrásellenőrzés eredményével együtt.
- 8Memória A beszélgetés összefoglalója a háttérben frissül, így a következő kérdés a korábbiakra épülhet.
Többszintű gráf-hibrid keresés
A keresés nem egyetlen lépés, hanem több szint együttműködése. A mondat- és az összefoglaló-szintű kulcsszavas keresés (BM25), az oldalak vektoros előszűrése (átlag- és összefoglaló-vektor alapján) és a szelektív tudásgráf-keresés közösen jelöli ki a keresési kört. A költségesebb, mondatszintű vektoros keresés már csak ezen a szűkített körön belül fut.
A tudásgráf (ArangoDB) a dokumentumokból kinyert entitásokat és kapcsolatokat tartalmazza. A rendszer szelektíven használja: csak azokat az oldalakat emeli ki, ahol a fogalom megkülönböztető erejű, így a gyakori fogalmak nem zajosítják a találatokat. Az összefoglalóban és a gráfban megtalált oldalak súlytöbbletet kapnak, a pontszámokat a rendszer összevonja, végül újrarangsoroló modell (BGE reranker) állítja sorba a találatokat. A szöveg-beágyazást E5 Large modell végzi.
Magyar nyelvre optimalizálva
A magyar nyelv ragozó jellegű, ezért a rendszer magyar lemmatizálót és entitás-felismerőt (NER) használ. A kérdésben szereplő ragozott alak így is megtalálja a dokumentumban szereplő szótövet. Az NLP-feldolgozás Apache Spark és SparkNLP alapokon fut.
A tudásbázis magyar nyelvre van optimalizálva, a rendszer azonban felismeri a kérdező nyelvét, és a nyelvi modell fordítási képességének köszönhetően a felhasználó a saját nyelvén kérdezhet és kaphat választ.
Agent-orchestráció, kódban rögzített vezérléssel
A rendszer eszközöket használ, és az összetett kérdéseket részkérdésekre bontja. Minden részkérdés előbb a saját koordinátorán fut át: az kiegészíti vagy lépésekre bontja a feladatot, és csak ezután futnak a feladat saját eszközei, amelyek megkapják a rész-lépések eredményét. A testvér részkérdések egymástól függetlenek, a végső kontextus mindegyik eredményét egyesíti.
Egy eszköz háromféle eredménnyel zárulhat: kontextust ad a válaszhoz, kész választ ad, vagy visszakérdezést kezdeményez. A kész válasz azonnal lezárja a kérést, a felesleges lépések pedig kimaradnak. A sorrendet nem a nyelvi modell, hanem a vezérlő alkalmazás kódja határozza meg.
Kontextus a csatlakoztatott rendszerekből
Nem kell mindent előre feltölteni a tudásbázisba. Az egyedi pluginként fejlesztett agentek a csatlakoztatott rendszerekből is képesek kontextust kérni egy kérdés megválaszolásához, egyedi API-konnektorokon vagy szabványos MCP-szervereken keresztül.
Hogy mikor, melyik rendszerből kell adatot kérni, azt a plugin fejlesztője dönti el, így a tudásbázis és az élő rendszerek adatai egyetlen válaszban találkozhatnak.
Minőségellenőrzés és mélykeresés
A válasz előtt egy minőségellenőrző lépés vizsgálja, hogy a kontextus tartalmazza-e a kért információt, és igazolt-e minden feltétel. Ha az információ nincs kimondva, vagy egy feltétel csak közvetetten igazolt, az ellenőrzés leszállítja a pontszámot.
Ha a kontextus nem elég, a mélykeresés előbb a releváns oldalak közvetlen környezetében keres, és csak ha ott sincs válasz, akkor tágítja a kört. Minden részeredményt az ellenőrző lépés újra megvizsgál a forrásoldalon, az elutasított idézet pedig visszakerül a következő kísérletbe. A végső válaszoló megkapja a kért információt, az idézetet, a döntést és a feltételeket.
Visszakérdezés
Ha egy eszköz azt jelzi, hogy hiányzik egy adat, a rendszer elmenti a teljes feladatot és a részben kitöltött kérést, és a kérdés kimegy a felhasználónak. A válasz gyors úton jut vissza ugyanahhoz az eszközhöz, amely újra kérdezhet, vagy végrehajtja a feladatot. Több kérdés is követheti egymást, körönként egy.
Miért a kód vezérel, és nem a modell?
Sok mai megoldás a nyelvi modellre bízza a folyamat irányítását: a modell dönti el, mikor hív eszközt, és milyen lépéseket tesz. Ez gyors prototípushoz jó, éles környezetben viszont a folyamat nem determinisztikus, nehezen naplózható, és a modell cseréje vagy frissítése megváltoztathatja a működést.
A Privát AI rendszer-alapú: az eszközöket a vezérlő alkalmazás aktiválja, koordinálja és sorrendezi. A nyelvi modell jól körülhatárolt feladatokat kap, például a kérdés nyelvének felismerését, normalizálását, a paraméterek kinyerését, az osztályozást és a végső választ. Minden döntés, prioritás és elágazás a kódban él, naplózható és tesztelhető, így a működés akkor is kiszámítható marad, ha a mögöttes modell változik.
Több domain, adatszintű elkülönítéssel
Egyetlen telepítésen belül több, egymástól adatszinten elkülönített domain futhat. Egy kórház például ugyanazon a rendszeren üzemeltethet betegdokumentációs, belső szabályzati és HR domaint is. Az elkülönítés az adatokon érvényesül: a keresés, az eszközök aktiválása és a tudásbázis tartalma mind a domain határán belül marad, az egyik domain adataihoz a másik kérései nem férnek hozzá.
A felhasználó a bejelentkezéskor, az integrációs hívások pedig a kérésben határozzák meg, melyik domainnel dolgoznak.
System: szűkítés a domainen belül
A domainen belül a system tovább szűkíti a hatókört. Egy egészségügyi domainben például a belgyógyászat és a kardiológia külön system lehet: azonos infrastruktúrán, de elkülönített adatkészlettel és akár eltérő eszközökkel. Ha a kérés system-szűrőt tartalmaz, a keresés és az eszközök aktiválása csak az adott system adataira és tool-jaira terjed ki.
Dokumentumok betöltése
A tudásbázis PDF- és DOCX-dokumentumokból, valamint weboldalakból építhető. A betöltés mögött egy LibreOffice-alapú konvertáló mikroszolgáltatás áll, ezért mindazokat a formátumokat támogatjuk, amelyeket a LibreOffice kezelni tud. A táblázatok felismerése OCR-rel is működik, így a szkennelt anyagok sem maradnak ki. A válasz igény szerint letölthető PDF-dokumentumként vagy strukturált (Markdown, JSON) kimenetként is elkérhető.
Fogalmak röviden
- Domain: egymástól adatszinten elkülönített tudásterület, például betegdokumentáció vagy HR.
- System: a domainen belüli további szűkítés, például egy szakterület.
- Tool (eszköz, agent): a platform alapegysége, egy feladatot megvalósító agent. Kontextust ad a válaszhoz, kész választ ad, vagy visszakérdez.
- Plugin: csomagolási egység, amely egy vagy több tool-t tartalmazhat, és futás közben tölthető be.
Minőségbiztosítás minden válasz mögött
Minden válasz mögött automatikus relevancia-értékelés fut, amely önhangoló küszöbbel figyeli a találatok minőségét. Gyenge találatnál a rendszer mélyebb, kiegészítő elemzést indít, mielőtt válaszolna. A beépített hűség-ellenőrzés azt méri, mennyire támaszkodik a válasz ténylegesen a visszakeresett forrásokra, ez csökkenti a hallucináció kockázatát.
Beépített minőségmérés
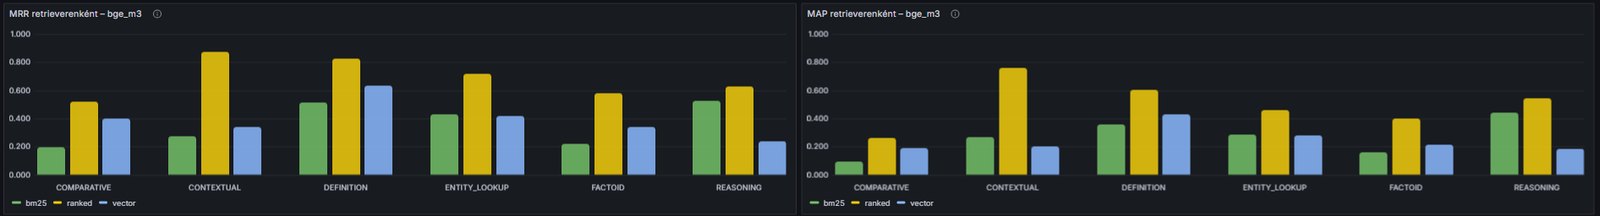
A platform metrika modulja a keresés minőségét szabványos információ-visszakeresési mutatókkal (MRR, MAP, nDCG, Success@k) méri, kérdéstípusonként és keresési módszerenként: BM25, vektoros és az összevont, újrarangsorolt keresés. A mérések Grafana műszerfalon követhetők.
Nyelvi modell: az Önök választása
A modellt vLLM szolgálja ki, OpenAI-kompatibilis interfésszel. Bármilyen nyílt modell használható, például Gemma, Llama, Mistral, Qwen vagy DeepSeek. A modell cserélhető anélkül, hogy a platform többi része változna.
Kész chatbot felület
A platform kész, azonnal használható chatfelülettel érkezik: streamelt válaszok, beszélgetés-előzmények, forrásmegjelenítés, világos és sötét téma. Külön fejlesztés nélkül is használható, ugyanakkor a platform API-n keresztül bármely meglévő rendszerbe beépíthető.
A beszélgetés-memóriát Redis adja.
Adminisztrációs felület
Az admin felületen kezelhető a teljes rendszer: itt hozhatók létre a domainek, itt tölthető fel az induló dokumentumkészlet, és itt szerkeszthetők a tudásbázis elemei is. Ugyanitt kezelhetők a felhasználók, a szerepkörök és a rendszerpromptok.
Ha a szervezet saját forrásból dolgozna, plugin fejlesztésével egyedi ingestion pipeline is kialakítható. Az integrációkról a fejlesztőknek szóló oldalon, a biztonsági megoldásokról a Biztonság oldalon olvashat.
Egyeztessünk, és megmutatjuk élőben.
A konzultáció és a demó mindig személyes, egyeztetett időpontban zajlik.
Frissítve: